Dr. Tobias Girschick – Biotecher und Data Scientist in der Automobilindustrie
- Host (Erium Podcast)Moderator
- Dr. Tobias GirschickSenior Data Scientist bei der Dräxlmaier Group
Überblick
In dieser Folge spricht der Host mit Dr. Tobias Girschick, Senior Data Scientist bei der Dräxlmaier Group. Das Gespräch beleuchtet seinen ungewöhnlichen Karriereweg von der Bioinformatik und Biotechnologie über IT-Beratung bis hin zur Automobilindustrie. Dabei kommen auch der Einsatz von Machine Learning zur Reduzierung von Tierversuchen sowie Einblicke in die Data-Science-Praxis im Industrieumfeld zur Sprache.
Über den Gast
Dr. Tobias Girschick hat ein Diplom in Bioinformatik sowie einen Doktortitel in Computer Science von LMU und TU München. Nach seiner akademischen Ausbildung arbeitete er als Senior Scientist und schließlich als Director for Chem and Bioinformatics bei der Priaxon AG, einer kleinen Biotech-Firma im Onkologiebereich. Anschließend wechselte er als Senior IT Consultant mit Data-Science-Schwerpunkt in die Beratungsbranche, bevor er seit knapp drei Jahren als Senior Data Scientist bei der Dräxlmaier Group in der Automobilindustrie tätig ist.
Zusammenfassung
Alltag als Senior Data Scientist in der Automobilindustrie
Tobias beschreibt seinen typischen Arbeitstag bei der Dräxlmaier Group als geprägt von Meetings, Planungsgesprächen und Teamkoordination. Da er eine Teamleiterrolle innehat, ist der tatsächliche Programmieranteil gering – ein Entwicklung, die er bewusst angestrebt hat. Das gelegentliche 'Einrosten' beim Coden nimmt er dabei in Kauf. Wenn er selbst programmiert, setzt er auf Python mit Pandas für Datenaufbereitung und -analyse sowie auf Keras bzw. TensorFlow für Deep-Learning-Projekte.
Data Science in der Biotech-Forschung: Moleküle, Dimensionen und Tierversuche
Bei der Priaxon AG verantwortete Tobias die Chemieinformatik-Abteilung und unterstützte die Geschäftsleitung bei der Erklärung, wie aus Milliarden theoretischer Moleküle die vielversprechendsten Kandidaten für klinische Studien herausgefiltert werden können. Ein zentrales Problem war dabei die geeignete digitale Repräsentation chemischer Moleküle – dreidimensionale Strukturen müssen so kodiert werden, dass Machine-Learning-Algorithmen sie verarbeiten können, ohne in den 'Curse of Dimensionality' zu geraten. Ein bedeutsamer Nebeneffekt dieser Methoden: Durch die gezielte rechnergestützte Vorauswahl lassen sich kostspielige Laborversuche und insbesondere Tierversuche deutlich reduzieren.
Unterschiede zwischen Biotech- und Automobil-Datenwelt
Im Vergleich zur Bioinformatik tritt das Dimensionalitätsproblem in der Automobilindustrie im Allgemeinen weniger stark auf, bleibt aber projektabhängig. Ein wesentlicher Unterschied liegt laut Tobias in der Datenverfügbarkeit: Als fest angestellter Data Scientist in einem Unternehmen hat er langfristigen Zugang zu den Datentöpfen und kann deren Aufbau aktiv mitgestalten – was in der projektgebundenen Beratung so nicht möglich war.
Karriereweg: Von Biotech über Beratung in die Automobilindustrie
Der Wechsel von der Biotechbranche in die IT-Beratung war einerseits ein lang gehegter Wunsch, andererseits wollte Tobias den aufkommenden Deep-Learning-Boom aktiv mitgestalten – etwas, das er in seiner damaligen Nische der Chemieinformatik als schwierig empfand. Den Schritt von der Beratung zur Dräxlmaier Group begründete er mit dem Wunsch nach einem Industrieumfeld, familiären Überlegungen sowie dem klaren Entwicklungspfad, den das Unternehmen ihm aufgezeigt hatte.
Einstieg in Machine Learning: Studium, Seminare und Diplomarbeit
Tobias kam über einen spezialisierten Machine-Learning-Lehrstuhl für Bioinformatik an der TU München mit dem Thema in Berührung. Ein Seminar führte ihn zu seinem Diplomarbeits-Betreuer, mit dem er seine erste praktische ML-Erfahrung in einer Münchner Biotech-Firma sammelte – konkret bei der Vorhersage von Eigenschaften chemischer Moleküle. Direkt anschließend promovierte er bei demselben Professor, ebenfalls mit Industriekooperationen, sodass er von Beginn an eine enge Verbindung zwischen akademischer Forschung und Praxis pflegte.
Rückblick und Lernmitnahmen: Lineare Algebra und Soft Skills
Auf die Frage, was er im Studium anders machen würde, nennt Tobias vor allem eines: der linearen Algebra mehr Aufmerksamkeit schenken. Ohne klaren Praxisbezug hatte er sich damals durch die Vorlesung 'durchgequält' – heute weiß er, dass sie das mathematische Fundament neuronaler Netze bildet. Als prägendes Erlebnis hebt er internationale Meetings in Japan hervor, die ihm die Bedeutung von Soft Skills und kulturellem Bewusstsein im Arbeitsalltag eindrücklich vor Augen geführt haben.
Deutschland als attraktiver Standort für Data Science in der Industrie
Tobias sieht Deutschland nicht allein wegen der starken Automobilindustrie als guten Einstiegsmarkt für Data Scientists, sondern vor allem wegen des hohen Automatisierungsgrads der deutschen Industrie – Stichwort Industrie 4.0. Dieser Automatisierungsgrad zieht eine hohe Dichte an Sensorik und damit eine gute Datenlage nach sich, was für Data-Science-Projekte in Produktion und Optimierung besonders vorteilhaft ist.
Kernaussagen
- Der Übergang von Biotech über Beratung in die Automobilindustrie war kein starrer Plan, sondern entstand aus einer Kombination aus Interesse, dem richtigen Timing beim Deep-Learning-Boom und persönlichen Umständen.
- Machine Learning in der Pharmaforschung kann dazu beitragen, Tierversuche zu reduzieren, indem vielversprechende Moleküle rechnergestützt vorausgewählt werden.
- Ein zentrales Herausforderung in der Chemieinformatik ist die verlustfreie digitale Repräsentation dreidimensionaler Molekülstrukturen für ML-Algorithmen.
- Als interner Data Scientist hat man langfristigen Zugang zu Unternehmensdaten und kann deren Qualität aktiv mitgestalten – ein Vorteil gegenüber der projektgetriebenen Beratung.
- Lineare Algebra bildet das mathematische Fundament neuronaler Netze – ihr Wert erschließt sich oft erst im Rückblick.
- Soft Skills und kulturelles Bewusstsein sind im internationalen Arbeitsumfeld ebenso entscheidend wie fachliche Kompetenz.
- Deutschlands hoher industrieller Automatisierungsgrad schafft eine gute Datenbasis und macht das Land zu einem attraktiven Umfeld für Data Scientists in der Produktion.
Fazit
Das Gespräch mit Dr. Tobias Girschick zeigt, dass ein unkonventioneller Karriereweg in der Data Science keine Schwäche, sondern eine Stärke sein kann. Breite Branchenerfahrung – von Biotech über Beratung bis zur Automobilindustrie – schärft den Blick für das Wesentliche: gute Daten, solides mathematisches Fundament und die Fähigkeit, mit Menschen unterschiedlicher Kulturen und Hintergründe zu arbeiten.
Für Studierende und Berufseinsteiger
Frühzeitig Berührungspunkte mit der Industrie suchen, lineare Algebra ernst nehmen und offen für Branchenwechsel bleiben – das sind die zentralen Ratschläge aus Tobias' Erfahrung.
Für Data Scientists mit Industrieinteresse
Die Automobilindustrie und andere stark automatisierte Branchen in Deutschland bieten eine solide Datenbasis für anspruchsvolle ML-Projekte – besonders für alle, die langfristig an Datenprodukten mitbauen wollen.
Volltranskript anzeigen
Speaker0: Ihr hört die IRIUM Podcast, der Data Science und Machine Learning Podcast für Studienabsolventen und Young Professionals.
Speaker1: Heute spreche ich mit Senior Data Scientist Tobias Gierschik. Wie kommt man von 1 Biotechfirma zur Automobilindustrie? Und wie kann Data Science die Anzahl an Tierversuchen in der Medizinforschung reduzieren? All das und noch mehr erfahrt ihr jetzt. Diplom in Bioinformatik und Doktor in Computer Science von der LMU beziehungsweise TU in München, fast 4 Jahre bei der Priaxon AG gearbeitet als Direktor vor Chem and Bioinformatics, anschließend Senior IT Consultant bei ITERA Tech und nun seit fast 3 Jahren Senior Data Scientist bei der Drexlmeier Group. Ich freu mich sehr, dass er da ist. Ich bin gespannt, was er uns zu erzählen hat. Tobias Kirschik. Hallo Tobias, freut mich, dass es klappt. Hallo Jaguar.
Speaker2: Freut mich auch, dass es klappt.
Speaker1: Ja, cool. Wie geht's dir? Wobei stell ich grade? Was hast Du denn bis heute schon alles so gemacht? Kannst Du uns bissel was erzählen?
Speaker2: Ich hab heute ehrlich gesagt seit Langem mal wieder fast den ganzen Tag seit 7 Uhr in der Früh mit Hecken verbracht.
Speaker1: Cool. Jetzt hattest Du ja angesprochen, dass das eher ungewöhnlich ist. Wie sieht denn sonst deine Arbeitsweise aus? Also aus was besteht denn so ein typischer Arbeitstag für dich bei der Drechselmeier Group?
Speaker2: Also für mich besteht der Arbeitstag größtenteils aus, sag mal Meetings, Planungsgesprächen und Ähnlichem. Der Programmieranteil ist bei mir, nachdem ich eigentlich schon sone Teamleiterposition hab, sehr gering.
Speaker1: Und bedauerst Du das? Eigentlich nicht.
Speaker2: Das war schon son bisschen auch mein Ziel in den in den letzten Jahren, weil das hat sich für mich einfach so ergeben über die Laufbahn, ne. Ich hab der Anteil an an Programmierung ist geringer geworden und irgendwann ist es dann natürlich so, wenn man nicht mehr täglich programmiert, dass man son bisschen eingerostet ist auch und einem dann schon auch schwerer fällt, flüssig Code zu schreiben, guten Code zu schreiben. Mhm.
Speaker1: Jetzt klingt das ja dann doch recht abwechslungsreich. Also Du hast quasi nicht unbedingt nur eine Draufsicht oder nur Hacking, sondern Du hast irgendwie eine Mischung aus beidem. Was würdest Du denn sagen, dass wenn Du, sag ich mal, mitm Coden beschäftigt bist, welches, sag ich mal, Tool aus der Machine Learning Toolbox verwendest Du denn am häufigsten? Oder was sagst Du, keine Ahnung, heut ist Clustering dran oder heut mach ich 'n 'n Network. Wie schaut's da bei dir aus? Hast Du quasi so ein Go To do Ding, was Du gerne benutzt? Also das sind, würd ich jetzt mal
Speaker2: 2 Teilen die Antwort. Einmal einmal das, was am häufigsten sicher auf der Tagesordnung dann steht, ist einfach, also wir benutzen nur Python und dementsprechend Python Panders, weil ja schon einfach der größte Anteil die die Datenaufbereitung, Datenanalyse ist in jedem Projekt. Go to oder Lieblingsding, Ding, würd ich schon sagen, Richtung Richtung Keras oder Tensor Flow dann, weil's einfach, sagen wir mal, mehr Spaß macht, jetzt mit den neuen Technologien und den neuronalen Netzen zu hantieren und dann zu sehen, dass dabei was Cooles rauskommt, als wenn man nur Daten miteinander verheiratet oder analysiert.
Speaker1: Genau. Also da da stimm ich dir zu, ja? Also für die, die sich die Jupiter Notebooks aus der ersten Staffel angeschaut haben, das war ja auch so mein erstes Herantasten an Machine Learning und und Data Science. Und da bietet CareAS tatsächlich einen sehr, sag ich mal, auch freundlichen Einstieg für mich. Und ich glaube, wenn man da dann noch mal tiefer einsteigen will, dann bietet CARAS da auch gute Möglichkeiten. Jetzt hatte ich ja eingangs erwähnt, dass Du, Du hast ja schon son paar Stationen hinter dir, ja. Also Du warst auch bei der Priaxon AG, wenn ich das, warum ich sprech das richtig aus, hast eine Diplom in Bioinformatik, Doktor in Computer Science. Kannst Du vielleicht erklären, was Du bei der Priaxon AG so gemacht hast? Also die Berufszeitung, die stand bei dir auf LinkedIn als Director for Chem and Bioinformatics.
Speaker2: Was hast Du da genau gemacht? Also bei der Priaxon vielleicht mal kurz dazu sagen, die Priaxon ist eine kleine Baatech Firma, die im Onkologiebereich Medikamentenvorentwicklung betreibt. Und ich hab da nach meinem Einstieg als Senior Scientist irgendwann die Chemieinformatikabteilung übernommen Und da beschäftigt man sich dann neben den, sagen wir mal, klassischen Datenthemen, wie speichere ich meine Daten? Wie muss ich meine Daten repräsentieren und abspeichern, sie effizient verarbeiten zu können? Auch mit Themen, auf welche auf welchen Texttag setz ich, nämlich irgendwie Java, nämlich C-Sharp, nämlich Python und Budgetthemen, Ressourcenthemen und so weiter. Und dann auch einfach Unterstützung der Geschäftsleitung bei Terminen mit extern, wo's darum geht, zu erklären, wie schafft das die Firma Priaxon, aus Milliarden von möglichen theoretischen Molekülen diejenigen rauszusuchen, die dann wirklich auch Sinn machen in klinischen Studien, die dann teuer in Labors synthetisiert werden. Der der Clou an der Geschichte ist oder war, dass man einfach viel Laborressourcen, also wir nennen das dann Wetlab, also wo wirklich Chemie, Biochemie, Biologie passiert, einfach viele Ressourcen sparen kann. Das ist jetzt auch aus aus ethischen und Gesetzgebergründen interessant, weil ich natürlich am Ende deutlich weniger Tierversuche zum Beispiel machen muss.
Speaker1: Also da tatsächlich eine 1 Reduktion und irgendwie Also das find ich tatsächlich sehr interessant, dass man da, sag ich mal, ethisch Also natürlich natürlich will immer jeder, dass irgendwie 'n gutes Ergebnis rauskommt, aber wenn dann da Tierversuche gemacht werden müssen, das zu reduzieren, ist natürlich auch wirklich eine 1 tolle Sache. Was mich jetzt noch interessieren würde ist, und zwar jetzt bist Du ja bei der Drexlmeier Group eher in der Automobilindustrie tätig. Wie siehst Du da denn Unterschiede in der Arbeitsweise? Also ich geborene dir mal 'n ganz konkretes Beispiel vielleicht. Also so konkret ist es auch nicht, ja. Du bekommst jetzt 'n Datensatz bei der Briaxon AG, mit dem Du arbeiten solltest. Und jetzt bekommst Du einen bei der Drexlmeier Group, mit dem Du arbeiten sollst, siehst Du da zum Beispiel auch vielleicht im Hinblick auf Unterschiede? Also sagst Du, in der Bierinformatik hab ich viel öfter als in der Automobilindustrie, aber dafür hab ich da mehr random Noise oder gibt's da welche Unterschiede für die Datenlage zum Beispiel?
Speaker2: Also ich denke im Bereich Missing Values und Noise eher weniger, denk, das ist wirklich projektspezifisch dann auch, wie hoch der Anteil zum Beispiel jetzt im Industrieumfeld an Sensordaten oder an händisch eingegebenen Daten und so weiter ist. Den Hauptunterschied, den ich sehen würde, ist, dass in der Bioinformatik beziehungsweise dann im im Spezialgebiet Chemieinformatik die chemischen Moleküle Ich hab immer einen oder noch jetzt immer einen gewissen Informationsverlust, weil ich eine geeignete Repräsentation im Rechner finden muss, mit dem ich die chemischen Moleküle oder vielleicht sogar die Proteine, also die Stellen im Körper, wo die Wirkung dann entfaltet werden soll, der der Medikamente darstellen muss, sodass den Machine Learning Algorithmus verstehen kann. Also ich muss ja eine dreidimensionale Struktur, das also 'n dreidimensionaler Graph mit Knoten und Kanten, Gewichten und Labels verlustfrei repräsentieren, ohne dass die der Datensatz zu stark in der in der Achse der der Spalten der Features aufgeblasen wird. Sonst komm ich ganz schnell natürlich wieder in das Dimensionsproblem. Und auch 'n Großteil meiner Doktorarbeit hat sich eben mit diesen Repräsentationen beschäftigt. Kann ich zum Beispiel die 3. Dimension weglassen? Kann ich sogar eine 1D String Repräsentation nehmen, bestimmte Probleme zu lösen? Da spielt sich sehr viel schon vorm eigentlichen Preprocessing, das man im klassischen Machine Learning hat, ab, was einfach
Speaker1: Domain Knowledge En Coding ist, sag ich mal, ja. Mhm. Kurz dazu, also die Hörer der ersten Staffel werden sich erinnern, Curse of Dimensionality, Dimensionality reduction, da scheinbar ein ganz großes Thema. Da hatten wir auch erwähnt, dass je mehr Variablen man hat oder je mehr Features man hat, desto schwieriger hat's am Ende des jetzt zum Beispiel Neural Network. Und wie schaut's da in der Automobilindustrie aus? Tritt es da dann weniger auf oder wie würdest Du das da vergleichen?
Speaker2: Also im Vergleich zu meiner Vergangenheit in der in der Pharma- oder Balttegeindustrie weniger, ist aber auch hier stark projektabhängig. Wenn ich jetzt, selbst wenn ich in der wenn ich Automobilindustrie mich auf Fertigung beschränke, hängt stark vom Produkt ab. Wenn ich jetzt 'n 'n Volumenprodukt hab oder 'n Zulieferprodukt von mir aus 'nem Bauteil, das ich mir nur anschaue, dann kann's sein, dass ich da im Jahr Milliarden davonfertige. Es ist aber natürlich bei uns in der Drechslerer Group so, wir fertigen keine Milliarden von von x 6 Türen fürn BMW, weil BMW keine Milliarden x 6 verkauft. Und dementsprechend bin ich da natürlich in der Anzahl der der Beispiele sehr stark begrenzt bei vielen Themen, aber eben nicht bei allen. Mhm.
Speaker1: Also wie immer projektabhängig und wie immer tut man sich schwer, eine allgemeine dafür zu finden, ist auch völlig richtig so. Dann kommen wir vielleicht noch werdegangstechnisch, würde mich noch interessieren, wie kam das denn dazu? Also ich, wenn ich das so höre von der Bioinformatik und zwischendurch ja auch noch Consultant, hab ich gesehen, also IT Consultant, wie wie kommt man denn dazu, dass also wie ist da dieser Sprung passiert zur Automobilindustrie? Bist Du jemand, der sagt, ich würd mich gern ausprobieren und und son bisschen durchwechseln oder ist das auf natürliche Art und Weise passiert? Was was kannst Du dazu erzählen? Das würde mich tatsächlich interessieren. Mhm.
Speaker2: Also ich teil's vielleicht auch wieder in in 2 Abschnitte die Antwort. Gerne. Der Übergang von vom Biotech in in die Beratung war erstens son bisschen dem geschuldet, dass ich immer schon damit geliebäugelt hatte, in die Beratung mal zu gehen. Und dann war das auch so Pi mal Daumen in der Zeitpunkt, wo diese ganze Deep Learning Geschichte richtig Fahrt aufgenommen hat. Okay. Das war was, wo meine Promotion eigentlich noch davor war und wo in in dem Bereich oder in der Nische, in der ich in der Chemieinomatik dann zu dem Zeitpunkt war, nicht gesehen hab, dass ich den den Zug voll mitnehmen kann. Und dann hab ich gesagt, ja, das ist eigentlich 'n superspannendes Gebiet und eigentlich gehört es zu meiner Kernkompetenz mit 'nem mit 'nem Doktor in natürlich angewandter, aber machine learning und wollte da einfach mitfahren sozusagen mit dem Zug und hab mich dann einfach umgesehen und eine gute Gelegenheit ergriffen und bin da in die Beratung gegangen. Und der Übergang von der Beratung, wo ich auch mit mit Schwerpunkt Data Science beraten hab, in die Automobilindustrie ist auch aus aus 2 Gründen. Einmal aus aus Interesse einfach mal was in der Industrie zu machen, was auch, sag mal, in in der Beratung hatt ich auch Industriekunden, da hab schon son bisschen Luft schnuppern können in der Richtung. Und dann ist es so, dass es bei mir auch familiäre Vorteile hatte, in in die Region Land zuzugehen. Und die Drechselmeier Gruppe auch 'n super Entwicklungspfad in der Richtung aufgezeigt hat. Und was dann noch dazukommt, die Datenlage ist natürlich, wenn ich in einem Unternehmen bin, eine andere, als wenn ich für Einzelprojekte immer wechseln muss in der Beratung. Also man kann sich 'n bisschen mehr austoben, weil ich natürlich die Möglichkeit hab, an den Datentöpfen noch mal rum zu schrauben beziehungsweise rumschrauben zu lassen. Also wenn was nicht passt an den Daten und ich hab 'n Grund oder ich kann irgendwie 'n schönes Projektziel oder Einsparung oder sonst was in Aussicht stellen, dann wird natürlich auch Geld in die Hand genommen, die Daten aufzubauen.
Speaker1: Cool. Ich würd gern noch bisschen in der Zeit zurückspringen, und zwar tatsächlich in der Zeit von deinem Studium beziehungsweise deinem Master und deinem deinem Doktor, ey, deinem Diplom und deinem Doktor. Und da würde mich tatsächlich interessieren, wie es denn Berührungpunkte mit Data Science oder Machine Learning gab. Also Du hast schon erzählt, in deiner Doktorarbeit hast Du auch Machine Learning verwendet, aber wie wie kam, also wie genau hast Du quasi Data Science und Machine Learning kennengelernt? Hast Du das aktiv selbst gemacht, weil Du da mal was im Netz gefunden hast? Oder gab's eine Vorlesung oder wie wie kam's kam es dir quasi dazu?
Speaker2: Zweiteres, also es gab bei uns in der Bioinformatik an der TU einen einen Lehrstuhl für Machine Learning und Data Mining in Bioinformatik. Sprich, Machine Learning speziell für Bioinformatik. Und da hab ich eben, da müsste ich lügen, Ende, Grundstudium, Anfang, Hauptstudium, Seminar belegt gehabt. Und bei dem Professor, der hat mir dann angeboten, bei ihm die Diplomarbeit zu schreiben. Mhm. Und der war eben Inhaber von diesem Machine Learning Lehrstuhl. Und zusätzlich gab's vorher auch schon eine Machine Learning Vorlesung an der LMU, an der Studiengang Bioinformatiker ist kombiniert, LMU und TU München zusammen. Und da hatte ich schon so ein, 2 Berührungspunkte im Seminar, musste ich dann ja auch einen Vortrag halten zu 'nem zu 'nem Machine Learning Thema. Und über über dieses Seminar und die Diplomarbeit, die ich dann zusammen mit dem Professor Kramer in 'ner anderen kleinen Balticfirma in München geschrieben hab, da hab ich eben dann schon die ersten 6 Monate aktiv Machine Learning Projekt gemacht. Da ging's Eigenschaftsvorhersagen von chemischen Molekülen, die in der, sag mal, Kette in diesem Prozess der Produktentwicklung in der Pharmaindustrie relevant sind. Und ja, da hab ich im Endeffekt dann Blut geleckt, würd ich sagen. Und direkt bei demselben Professor eine Promotionsstelle auf Drittmitteln in wieder mit Industriekooperationen gemacht, sodass ich auch immer schon diese Schnittstelle zur Industrie hatte.
Speaker1: War auch schon ganz oft Thema bei uns im Podcast, dass man quasi während dem Also Leute von der Hochschule tun sich da dann oft son bisschen leichter, hat man das Gefühl. Aber wenn man dann quasi an der Uni ist, da dann tatsächlich 'n coolen Bezug zum zur Praxis zu bekommen, indem man halt auch eine Schnittstelle zur Industrie hat, da muss man fast schon oft selber auch Ausschau halten. Was würdest Du denn in deinem Studium vielleicht mit deinem Wissen von jetzt, im Nachhinein ist man immer bisschen schlauer, was würdest Du denn da vielleicht anders machen? Also gibt's vielleicht 'n Modul, wo Du gesagt hättest, ne, hätte ich das vielleicht doch belegt oder hätt ich mehr Mathe machen sollen? Gibt's da was, wo Du sagst, das fehlt mir?
Speaker2: Ja, also jetzt im Nachhinein würde ich vielleicht, leichtsinnigerweise sagen, in linearer Algebra besser aufgepasst zu haben, hätte im Nachhinein nicht geschadet.
Speaker1: Okay.
Speaker2: Weil natürlich die lineare Algebra, die ist bei uns im Grundstürme erstes, zweites, drittes Semester irgendwann gewesen, relativ tief eigentlich, aber da habe ich mich damals son bisschen, also mal durchgequält, waren relativ harte Vorlesungen und da war mir der Praxisbezug auch nicht so ganz klar. Und es ist natürlich so, dass die lineare Algebra die Grundlage für die neuronalen Netze ist, ja. Und ja, das hab ich mir dann später noch mal gegeben.
Speaker1: Mhm. Ja, Dito. Also ich mich hat mich hat's auch immer gedauert, aber jetzt hab ich auch erst selber während dem Master noch mal, sag ich mal, den Wert son bisschen mehr schätzen gelernt und auch verstanden, was es da eigentlich geht, ne. Weil weil man Genau. Da immer vielleicht für die, die die sone Vorlesung schon mal besucht haben, man denkt da zuerst irgendwie, ja, ich denk an Blöcke von Zahlen und das macht man dann 2 Semester lang oder 1, je nachdem wie dann die Vorlesung dauert. Aber dass da mehr dahinter stecken kann, genau, lernt man dann später kennen. Aber so viel dazu. Dann vielleicht jetzt mit 1 mit einem Blick auf alles, was Du jetzt quasi so bisher erlebt hast, universitär und beruflich. Gibt's denn da ein Ereignis, sei es jetzt als von der Nathal als Konstant, ja Consultant, als Data Scientist bei Drexlmeier, als Director of Chem- und Bioinformatics oder eben während deinem Studium, gibt's da ein Ereignis, wo Du sagst, das war besonders prägend oder besonders außergewöhnlich?
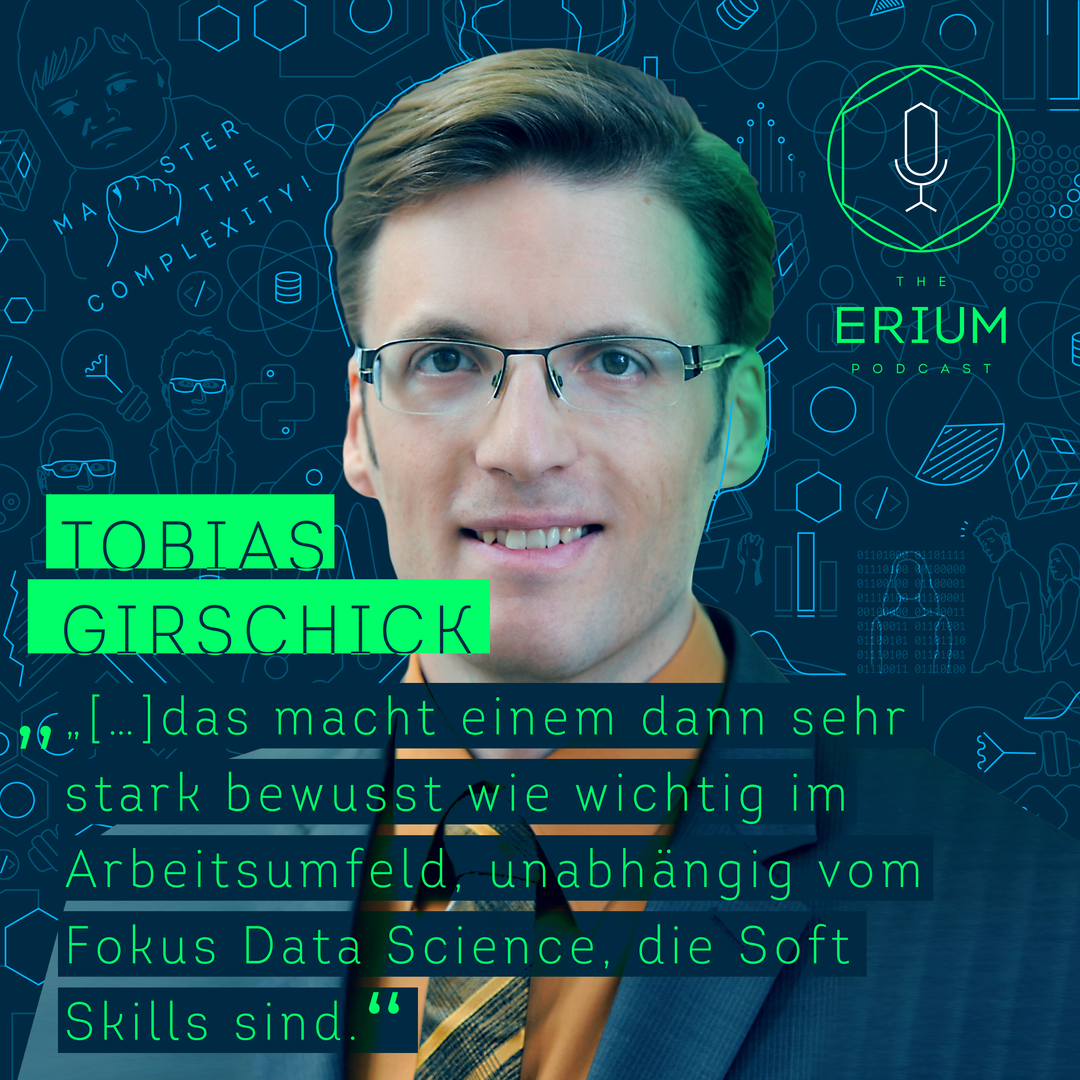
Speaker2: Ist schwierig, aber vielleicht Ich war in der Zeit in der Biotechindustrie relativ viel unterwegs auch Mhm. Zusammen mit dem CTO von der Preaxon zu Merge and Acquisition Gesprächen, wo's Projekt Merge und so ging und war dort auch in Japan mehrmals. Und das macht einem dann sehr stark bewusst, wie wichtig im Arbeitsumfeld, jetzt unabhängig vom Fokus Data Science, die Soft Skills sind, ja. Weil man da natürlich in soner ganz anderen Welt dann landet, wenn man in Japan dann die Schuhe auszieht vorm Meeting und da die Hierarchien verstehen muss im Meeting, damit man überhaupt zu 'nem Ergebnis kommen kann. Aha. Sonst kann man sich den den Flug über über den den russischen Kontinent, sag ich jetzt mal, sparen.
Speaker1: Also tatsächlich auch kulturelles Bewusstsein irgendwie haben, bevor man so was angeht.
Speaker2: Ja. Und das ist auch was, was natürlich in 'nem internationalen Konzern dann zählt. Das ist, wenn man in 'ner kleinen, lokalen Firma ist, ist das kein Problem. Sobald man im internationalen Konzern arbeitet, hat man dann unter Umständen auch Kollegen, wo einfach 'n starken kulturellen Unterschied haben. Und da muss man halt einfach auch mit offenen Augen drangehen oder dann auch Schulungen machen, weil das sind Dinge dabei, die kann man nicht wissen. Mhm.
Speaker1: Und es wär auch einfach schade, wenn's dann an so was scheitert, ne. Also ich mein, das sind ja oft einfach Sachen, die leicht umzusetzen sind. Okay, mal mehr, mal weniger, aber wie das jetzt mit den Schuhe ausziehen zu machen wär, das sollte man ja noch hinkriegen und daran soll's ja nicht scheitern. Cool, dann würd ich jetzt zum Abschluss jetzt noch eine letzte Frage stellen, die mich persönlich auch sehr interessieren würde. Und zwar, was würdest Du jetzt denn jetzt sagen, auch im Blick auf Deutschland und na ja Deutschland auch eine sehr starke Automobilindustrie hat, Wie es jetzt zu Zeiten von Corona ist, vermag ich jetzt nicht zu zu behaupten, aber Deutschland war ja schon auch immer sehr bekannt dafür. Wie bietet sich's da speziell an, mit Data Science in die Produktion zu gehen, ne? Weil beim Podcast wollen wir immer beleuchten, mit Data Science kann man wirklich an viele Ecken gehen. Aber würdest Du sagen, speziell in Deutschland bietet sich's da, hat man findet man einen leichteren Einstieg, einfach weil die die Automobilindustrie so stark ist? Ich denke schon
Speaker2: und zwar nicht zwingend allein, weil die Automobilindustrie so stark ist, sondern meiner Meinung nach eher, weil der, sag mal, erstens kommt Industrie 4 Punkt 0 son bisschen aus Deutschland und der Automatisierungsgrad ist höher. Und mit dem Automatisierungsgrad steigt die Datenqualität und die Datenmenge. Und das ist, denk ich, der der ausschlaggebende Punkt. Alles, was natürlich Richtung autonomes Fahren geht und so, ist da noch mal extra zu sehen. Aber grad, wenn's Optimierung von Produktion, Maschinen, Produkt geht. Da sind wir schon auf 'nem sehr hohen Level in Deutschland Mhm. Durch die Automatisierung. Aber hier noch 'n Schritt weiterzukommen, ist ist dieser hohe Automatisierungsgrad und damit natürlich auch eine hohe Bestückung mit Sensorik sicher 'n Pluspunkt. Mhm.
Speaker1: Sprich, es gibt für Data Scientists auch tatsächlich was zum Arbeiten oder es gibt Dinge, mit denen sie einfach arbeiten können. Und oft ist die Datenlage, sag ich mal, einfach, sag ich mal, sehr gut für einen Data Scientist. Ja, definitiv. Cool. Dann Tobias, freut mich sehr, dass Du da warst. Vielen Dank und ich wünsch dir noch alles Gute und viel Erfolg bei deiner Arbeit bei Drexlmeier. Toll, dass Du da warst, Tobias Gierschik. Vielen Dank, hat mich gefreut. Das war mein Gespräch mit Tobias Gierschik. Besonders spannend fand ich, dass er schon viele Stationen durchlaufen hat. Von Biotech, zur Beratung, zur Automobilindustrie. Wie ist da eure Mentalität? Habt ihr einen in Stein gemeißelten Zehnjahresplan für euer Leben? Oder bleibt ihr doch lieber etwas flexibler? Schreibt es mir auf unseren Social Media Kanälen. In seiner Doktorarbeit hat Tobias auch gegen den Curse of Dimensionality gekämpft. Was das genau ist und wie man dagegen vorgeht, erfahrt ihr in der Folge Dimensionality Reduction aus unserer ersten Staffel. Master the Complexity.
Speaker0: Jeden Dienstag erscheint eine neue Folge von The Erium Podcast. Auf dem Laufenden zu bleiben, folgt uns auf Facebook, Instagram, Twitter und LinkedIn. Wenn ihr uns unterstützen wollt, gebt uns eine 5 Sterne Bewertung auf Apple Podcasts, folgt uns auf Spotify und