Drücken Data Scientists nur auf PLAY?
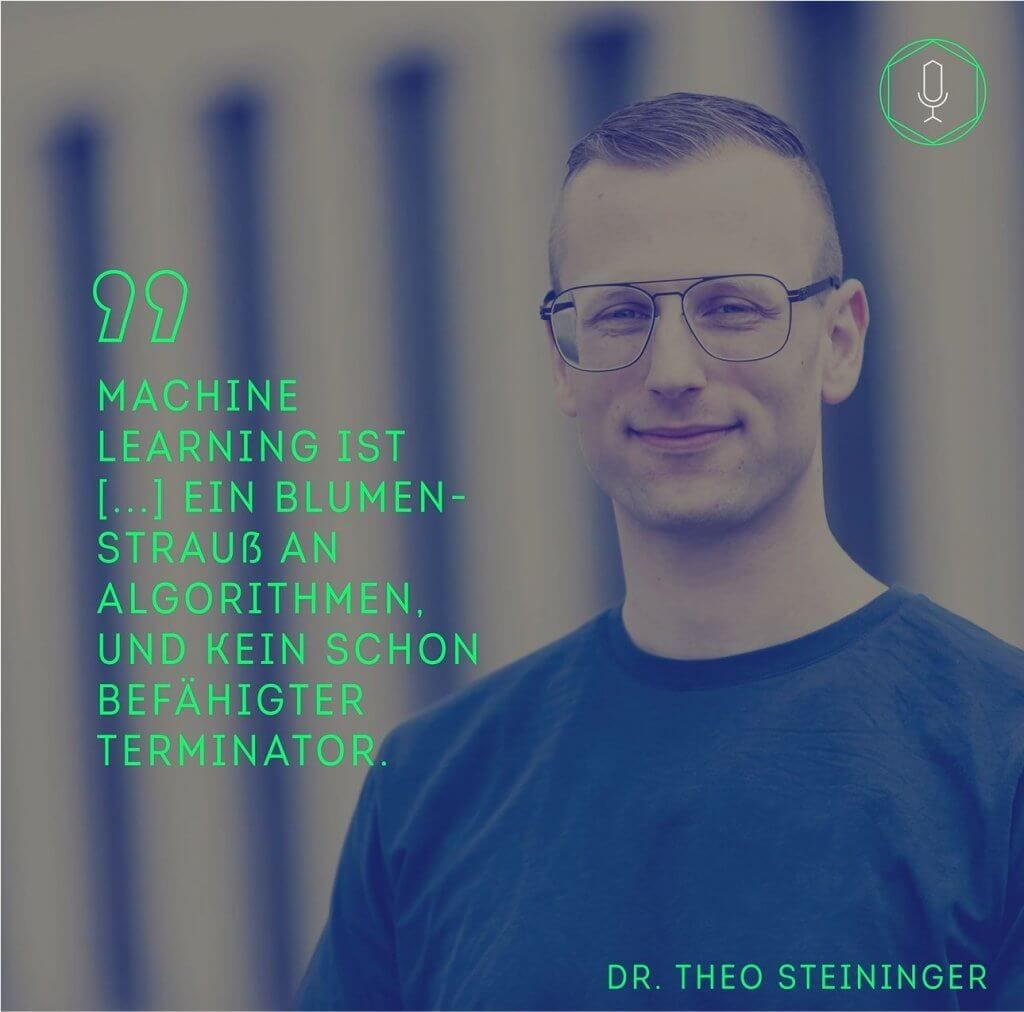
- Dr. Theo SteiningerCo-Founder & CEO at Erium
- Dr. Maksim GreinerCo-Founder & CTO at Erium
- Jaguar (Moderator/Co-Host)Podcast Host
- Silvia (Zitat aus anderer Folge)Guest voice from an earlier episode
Overview
In this episode of the Erium Podcast, Theo and Maksim join the host to discuss the widespread misconception that data scientists simply press a button and AI does the rest. Drawing on concrete project experiences and a clip from an earlier episode, they explore why human expertise remains indispensable in the data science process. The episode is aimed at recent graduates and young professionals who want a realistic picture of what day-to-day life as a data scientist actually looks like.
Summary
The Push-Button Myth: Inflated Expectations of AI
One of the most common public misconceptions is the idea that AI works like a magic button: feed in data, get a model out, problem solved. Theo and Maksim share from their project experience that clients frequently expect an AI to independently identify which process model is needed, or to automatically transform raw data into actionable insights. Both see this hype as the result of years of exaggeration by marketing departments and AI evangelists.
IBM Watson as a Cautionary Tale: When Marketing Outpaces Reality
Theo cites IBM Watson as a particularly striking example of inflated AI promises. After Watson's spectacular victory on Jeopardy, the impression arose that we had entered the age of an all-knowing, problem-solving system. Theo references a critical perspective suggesting that Watson was primarily a marketing vehicle for selling consulting hours. He interprets IBM's subsequent loss of major mandates as a direct consequence of overpromising to clients. The well-known quote 'Machine Learning is nothing but fancy interpolation' neatly captures the sober reality.
The Cost Function as the Core Task: Expert Knowledge Cannot Be Automated
A clip featuring Silvia from an earlier episode makes the point clearly: while there are algorithms that learn parameters on their own, the higher-level meta-parameters and, above all, the cost function must be defined by a human. The cost function encodes the goal of the project - what model behaviour is ultimately desired. Maksim adds that when clients are asked how to weight multiple quality objectives, they often realise they have never explicitly thought about it before. Formulating these goals is an intellectual task that no AI can take over.
Matchmaking as Core Competence: Real Problems Meet the Right Tools
Maksim describes the actual work of data scientists as 'matchmaking': abstracting a real-world problem and then finding the appropriate methodological tool. Generic tools deliver mediocre results, while highly specialised tools never fit perfectly. At Erium, the conclusion drawn from this is to model the process itself - the so-called Halerium Graph - and from it automatically generate a tailor-made tool for each specific use case.
Data Scientist as Craftsperson, Not Magician
The group's conclusion is clear: data scientists are not magicians but craftspeople who deploy various tools with precision and who rely on the client's domain knowledge as an essential input. Transparency in the approach - the concept of whiteboxing - and a consistent focus on solving the problem rather than applying off-the-shelf tool packages are decisive. The question 'What do you actually want to achieve?' remains the most important and indispensable one throughout the entire process.
Key takeaways
- The idea that AI handles everything at the push of a button is a marketing-driven myth that leads to inflated expectations in real projects.
- Cost functions and meta-parameters must be defined by humans - this intellectual work cannot be automated.
- Formulating clear objectives (what should the AI actually optimise?) often forces clients to explicitly articulate their priorities for the very first time.
- IBM Watson is a cautionary example of what happens when marketing promises far exceed the actual capabilities of the technology.
- The core competence of data scientists lies in matchmaking: abstracting real-world problems and finding the right methodological tool.
- The Erium approach of explicitly modelling the process (the Halerium Graph) turns the unavoidable abstraction work into an automatically generated, tailor-made tool.
- Whiteboxing and a problem-oriented approach instead of tool packages create transparency and better outcomes.
Conclusion
Data scientists are neither magicians nor mere button-pushers. Their true value lies in the ability to abstract real-world problems with precision, formalise goals mathematically, and select or build the right methodological tool. As long as machines cannot decide for themselves what a human actually wants to achieve, human expertise remains the decisive success factor in every AI project.
For beginners and young professionals in the data science field
This episode provides a realistic picture of everyday professional life: expect not magic, but craft-level precision, structured problem-thinking, and close collaboration with domain experts.
For decision-makers and clients in AI projects
Anyone commissioning AI projects should understand that formulating clear goals and prioritising quality criteria is not something the AI takes care of - it is an indispensable human prerequisite that largely determines the success of the project.
Show full transcript
Speaker0: Ihr hört die IRIUM Podcast, der Data Science und Machine Learning Podcast für Studienabsolventen und Young Professionals.
Speaker1: Bei echter KI braucht man keine Data Scientists, sonst wird's ja nicht künstliche Intelligenz heißen. Wozu also Data Scientists? Theo, Maxim, was sagt ihr dazu?
Speaker2: Ja, das kennen wir auch. Ich muss da immer 'n bisschen dran denken, wenn irgendwie über so elektronische Musik DJs gesprochen wird, der hat doch nur auf Play gedrückt, ja? Warum kommen da 20000 Leute zu dem Konzert? Ja, da ist da ist definitiv 'n Missmatch zwischen der Erwartungshaltung und was macht eigentlich der Data Scientist den ganzen Tag?
Speaker3: Auf jeden Fall. Und wir haben bei der Folge der Silvia da auch 'n ganz coolen Ausschnitt. Jaguar magst Du den mal einspielen?
Speaker1: Den Spiel mal ein.
Speaker4: Ich denke, dass der Eindruck besteht, dass da weniger Arbeit auf Seite von 'nem Data Scientist notwendig ist. Okay. Also manchmal besteht diese diese Vorstellung, dass ein Knopfdruck, dann werden Daten aufgenommen, automatisch wird 'n Modell trainiert und dann genügt es schon. Aber es ist eben ganz entscheidend, dass dass jeder Algorithmus noch übergeordnete Parameter hat, Metaparameter, die auch gewählt werden müssen. Und gerade, was auch 'n wichtiger Punkt ist, ist die Wahl der Kostenfunktion. In bei der Wahl der Kostenfunktion fließt das Expertenwissen mit ein. Da darin legt der Experte fest, welches Modell erwünscht ist, welches Modellverhalten im Optimalfall rauskommen soll. Mhm. Und dieses, ja, dieses Expertenwissen, das da sehe ich nicht die Möglichkeit, das komplett zu automatisieren und da geht tatsächlich viel, viel Zeit rein von uns, ja. Sich mit dem Experten eben abzusprechen.
Speaker1: Aha, okay. Der berühmte Button also, der alles von alleine macht. Ja, dann erzählt doch mal, wann wurdet ihr denn das letzte Mal für einen Zauberer gehalten mit 'nem Button, der alle Probleme löst und den Roboter her zaubert, der alle Prozesse von alleine optimiert? Könnt ihr uns dazu was erzählen?
Speaker2: Also tatsächlich, dass Leute dachten, boah das war jetzt magic. Das hatte ich mal, als ich 'n paar Studenten gezeigt hab, wie man so die Digititerkennung am Amnest Beispiel macht. Aber jetzt so in in Projekten und so was haben wir tatsächlich eher so diese überzogenen Erwartungshaltungen und viel gesehen. Also so Zitat so, ich erwarte von 1 KI, dass die das selbst erkennt, wenn man so sagt, ja, hier müssen wir 'n Prozessmodell reinbringen oder so was. Oder auch nett war ja das Versprechen der KI ist doch, dass die das alles von selber erkennt und man nur die Daten reinfüttern muss. Wieso denn jetzt der ganze Aufwand in dem Projekt? Und ich denk, da wurde einfach viel Hype erzeugt, was Machine Learning angeht und KI im Allgemeinen. Und als Data Scientist badet man das jetzt 'n bisschen aus. Also da sind einfach große Missmatches und ich glaub, in den letzten Jahren, also wenn man so 5 Jahre zurückblickt, da wurd einfach sehr viel von Evangelists und Marketingabteilungen versprochen, was 'n bisschen überzogen war.
Speaker3: Also ein Beispiel, das mir da neulich wieder aufgekommen ist, das ist tatsächlich IBM Watson, Ja, so cool wie IBM Watson ist. Am Ende war das, denke ich, ein Bärendienst für die ganze Branche, denn es ist aus meiner Sicht da der Eindruck entstanden, ja, wir sind jetzt so in der Terminator Age, nur im besten Sinne und IBM Watson löst jetzt alle Probleme, weil schließlich haben wir Jaepperdie geknackt. Im Gegenzug dazu, ich hab mal jetzt erst vor Kurzem auch wieder das Statement gehört von jemandem, der gesagt hat, na ja, IBMWatson war 'n riesiger Marketing Gag, Beraterstunden abzusetzen der Data Scientisten, die bei IBM arbeiten. Und das ist natürlich eine interessante Perspektive und ich hatte auch einen Artikel mal gesehen, dass das IBM tatsächlich ja auch auf die Füße gefallen ist, dass die 'n großes Mandat wieder verloren haben, weil die dem Kunden vermutlich, so interpretiere ich das, einfach zu viel auch versprochen hatten, was die Technologie schon zu leisten imstande ist. Und am Ende, wir kennen ja das Zitat jetzt schon zu Genüge, Machine Learning is nothing girls tant fancy interpolation Und 'n Blumenstrauß an Algorithmen und kein schon total befähigter, na ja Terminator im Sinne von Helferlein, der mir im Alltag unter die Arme greift. Maxim, wie geht denn dir das? Du hast jetzt halt in der Vergangenheit ja eine Vielzahl an Projekten auch bei uns in der Firma betreut. Mhm. Und wir haben ja auf der einen Seite einen fetten Werkzeugkasten auch aufgebaut die letzten Jahre. Auf der auf der anderen Seite hat der Kunde aber ein Problem und den interessiert ja herzlich wenig, welches Werkzeug, ob jetzt 'n Schraubenschlüssel oder eine Rohrzange da zum Einsatz kommt im übertragenen Sinn. Vielleicht kannst Du ja kurz auch noch mal drauf eingehen, wie wie wie wir uns jetzt dem Problem da genähert haben. Einfach diese beiden Sichtweisen zu verlieren. Ja, gern. Also grundsätzlich sehe ich so dieses Problem.
Speaker2: Man hat halt entweder so sehr generische Werkzeuge, diese passen auf vieles, aber machen immer so mittelmäßige Ergebnisse. Oder man hat halt son sehr, sehr großen Blumenstrauß an diesen hochspezialisierten Werkzeugen, die dann aber nie hundertprozentig auf das passen, was ich jetzt grad in der Realität hab, ja. Dann hab ich da irgendwie, okay, jetzt ist es hier eine Schraube und ich hab jetzt hier mal son Hammer, der ungefähr passt. Und das ist immer nicht so ganz befriedigend und ein großer Teil ist dann ja dieses Matchmaking. Ist ja die Arbeit des Data Scientisten, das Real Life Problem zu abstrahieren und dann die das das na das Werkzeug zu finden, was am nächsten dran ist. Und was macht dieses Matchmaking aus? Ist wie sieht 'n das in echt aus? Was hab ich da für 'n Prozess vor mir? Und wir haben uns ja deswegen dafür entschieden, dass wir dann gleich sagen, na ja, dann modellieren wir doch diesen Prozess. Also abstrahieren den, wenn ich das sowieso machen muss im Kopf. Und wenn wir den abstrahiert haben, dann nehmen wir das einfach als das quasi Custom Werkzeug für diesen Prozess her. Das ist ja immer dieser Herium Graph, von dem wir schon öfter gesprochen haben. Das heißt, wir haben da jetzt gesagt, na ja, wenn's irgendwie immer ist, dann machen wir aus der Not eine Tugend und sagen, dann hat man immer sein Werkzeug für diesen Use Case, wenn man mit dem Abstrahieren fertig ist automatisch.
Speaker3: Und was dir Silva da auch gesagt hat, war der Bezug auf die Kostenfunktion. Also dass Du dir ja übersetzt erst mal Gedanken dazu machst, was ist dein Ziel, wo möchtest Du hin? Und also, ich sehe nicht, dass auf absehbare Zeit einem diese Arbeit auch abgenommen wird, dass ich mir überlegen muss, was möchte ich eigentlich erreichen? Ja. Also gibt es in irgend 'ner Branche, jetzt mal im Ernst, gibt es in irgend 'ner Branche, dass mir ein Tool die Denkleistung abnimmt, was ich überhaupt erreichen möchte? Also mir fällt dazu nichts ein und dementsprechend finde ich's auch irgendwo verwunderlich, dass die Leute so sich so auf den Standpunkt stellen, na ja, okay, KI nimmt mir jetzt das Denken ab. Also im Sinne von, die künstliche Intelligenz ist jetzt meine. Mhm.
Speaker1: Sprich, es gibt einfach noch kein Spracherkennungstool, was nicht nur den Text aufnimmt, sondern auch den Inhalt und die zugrunde liegenden Mechanismen des die da die dahintersteckst.
Speaker2: Es ist heftiger als das. Die Frage wurde sich vorher vielleicht teilweise noch nicht gestellt. Wenn Du in der Optimierung bist, in der mathematischen Optimierung, dann bist Du gezwungen diese Kostenfunktionen von der wir sprechen aufzuschreiben. Und wenn Du dann häufig dann fragst, ja okay, ihr habt jetzt diese 5 Qualitätsparameter, Welcher ist denn wie wichtig? Ja, die sind alle wichtig. Okay, aber wenn wir jetzt einen Tod sterben müsst, ja? Also okay idealerweise erfüllen wir alles zu 100 Prozent, aber let's be real. Ich seh doch, wir würden doch gar nicht sprechen, wenn ihr das erreichen würdet. Also was ist 'n guter Kompromiss? Was ist 'n schlechter Kompromiss? Daraus leitet sich ja dann diese Kostenfunktion letztendlich ab. Und alleine diese Fragen zu konkretisieren und dann den Kunden zu zwingen, darauf Antworten zu geben, dann daran merkt man ja schon, dass da einfach gewisse Gedanken noch nicht gedacht wurden, weil eben das Thema Optimierung noch nie so mathematisch angegangen wurde. Und das kann dir keiner abnehmen, ja?
Speaker3: Wir stellen da ja auch nur zielgerichtete Fragen. Ja, ja. Na ja, und am Ende, also ich sehe halt die die Perspektiven Transparenz schaffen, dass wir so so Whiteboxing möglich wie, ja, so Whiteboxing mäßig wie möglich reingehen. Und was ich für mich auch sehr erkenntnisreich fand, war nicht Werkzeuge im Package anzubieten, sondern von der Problemlösung her zu fragen, was möchte es denn erreichen? Und wir damit sozusagen Methoden Templates irgendwas stellen über die Objective Classes. Also was, Du möchtest eine Vorhersage rechnen? Okay, give was the graph and the data, ja? Und der Rest, den erledigen wir. Aber diese initiale Frage, das ist das wär ja auch so, wie wenn ich Text to Speech, nee, Speech to Text einsetze als Schriftsteller, mein Buch zu selektieren und erwartet von der Software, dass die mir dann vor allem auch Rückmeldung gibt, na ja, also jetzt pass mal auf, der Plot ist irgendwie scheiße. Die Story macht keinen Sinn, ja.
Speaker1: Ja. Abschließend lässt sich also sagen, dass Data Scientists weniger Zauberer sind als eher Handwerker, die sich einfach verschiedener Werkzeuge bedienen und insbesondere natürlich auch, das klingt jetzt etwas weird, den Kunden etwas als Werkzeug verstehen, sein Wissen zu nutzen und dem Ziel vielleicht etwas näherkommen.
Speaker2: Ich hätt's jetzt besonders auf den Kunden bezogen leichter dann von mir, aber Wir sind ja unter uns, das hört ja niemand, ne. Also wir schneiden das ja alles raus. Was? Genau.
Speaker0: Jeden Dienstag erscheint eine neue Folge von The Erium Podcast. Auf dem Laufenden zu bleiben, folgt uns auf Facebook, Instagram, Twitter und LinkedIn. Wenn ihr uns unterstützen wollt, gebt uns eine 5 Sterne Bewertung auf Apple Podcasts, folgt uns auf Spotify und empfehlt uns weiter. Bis zum nächsten Mal bei The IRIUM Podcast.